Gift im Korpus: Das Gegenmittel in Sicht
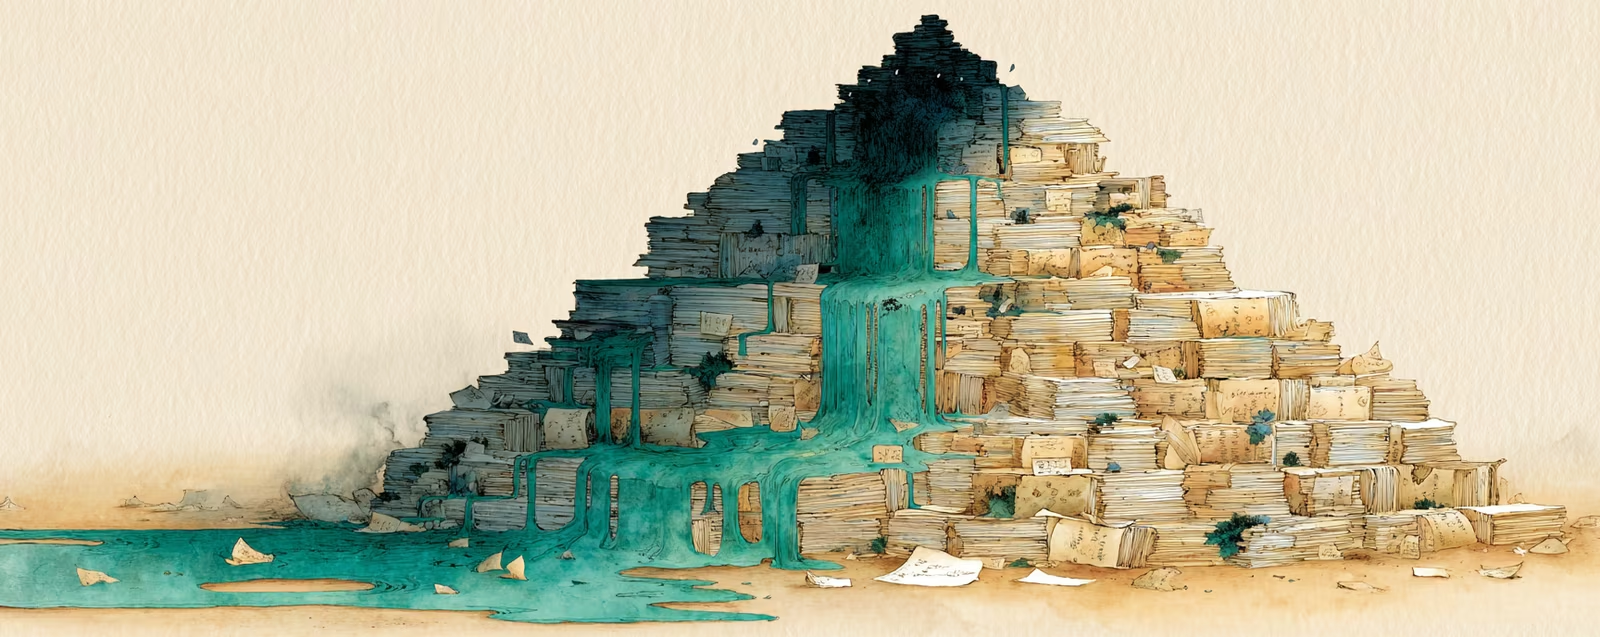
Letzte Woche war ich auf der data:unplugged in Münster, einer sehr kommerziellen Veranstaltung, die mehr Fragen aufgeworfen als beantwortet hat, mich nun aber doch zum Nachdenken angeregt hat. Am Schluss seiner Keynote hat Sascha Lobo etwas gesagt, das hängen geblieben ist: Wenn ich ihn richtig verstanden habe, argumentierte er, dass wir eine positive Vision für eine Gesellschaft mit AI brauchen, denn wenn wir keine entwickeln, kommt der Doom ganz sicher.
Ich glaube, Sascha Lobo hat recht. Es ist allzu leicht, sich hundert Varianten auszumalen, wie die AI-Revolution schiefgehen kann. Massenarbeitslosigkeit. Autonome Kriegsführung. Totale Überwachung. Die dystopischen Möglichkeiten liegen auf der Hand; keine davon ist unrealistisch, manches ist schon im Gang.
Ich möchte aber die Aufforderung von Sascha Lobo aufgreifen und über einen Bereich sprechen, in dem AI die Menschheit und die Gesellschaft tatsächlich verbessern kann und der, wie ich am Ende darlegen möchte, wiederum einen notwendigen Schritt zur Weiterentwicklung künstlicher Intelligenz darstellt.
Das unvollendete Projekt
Vor zwei Wochen ist Jürgen Habermas gestorben. Man könnte meinen, das sei eine Nachricht für die Feuilletons, für die philosophischen Seminare, für Menschen, die gerne über Diskursethik reden. Aber da mein altphilologischer Vater sicher Wert auf den philosophischen Kontext gelegt hätte, möchte ich diese Perspektive kurz in meinen Diskursraum holen:
Immanuel Kant hat 1784 die Frage gestellt, was Aufklärung sei, und eine Antwort gegeben, die bis heute trägt:
„Aufklärung ist der Ausgang des Menschen aus seiner selbstverschuldeten Unmündigkeit.“
— Immanuel Kant, 1784 [13]
Sapere aude: Habe den Mut, dich deines eigenen Verstandes zu bedienen. Das war kein akademischer Appell. Das war ein politisches Programm: Vernunft, nicht Autorität, als Grundlage menschlichen Zusammenlebens. Und Wissenschaft als institutionalisierte Praxis dieser Vernunft.
Karl Popper hat 1934 das fehlende Scharnier zwischen Aufklärung und wissenschaftlicher Praxis geliefert [19]: Nicht was sich beweisen lässt, macht eine Theorie wissenschaftlich, sondern was sich widerlegen lässt. Falsifizierbarkeit als Demarkationskriterium. Elf Jahre später, unter dem Eindruck zweier Weltkriege, hat er in The Open Society and Its Enemies [20] den Bogen zur Politik geschlagen:
“The secret of intellectual excellence is the spirit of criticism; it is intellectual independence.”
— Karl Popper, 1945 [20]
Wo Kritik unterdrückt wird, in der Politik wie in der Wissenschaft, entsteht Geschlossenheit. Und Geschlossenheit ist der Anfang vom Ende.
Habermas hat diesen Gedanken weiterentwickelt und politisch zu Ende gedacht: Rationaler Diskurs, also der evidenzbasierte Austausch von Argumenten im öffentlichen Raum, ist das Fundament, auf dem demokratische Gesellschaften ihre Legitimität gründen [14]. Nicht Macht. Nicht Tradition. Nicht Glaube. Sondern die gemeinsame Verpflichtung auf Vernunft. Er nannte die Aufklärung ein „unvollendetes Projekt der Moderne“: nicht gescheitert, aber noch nicht eingelöst.
Warum erzähle ich das in einem Text über AI und Wissenschaft?
Weil Wissenschaft, wenn Kant, Popper und Habermas recht haben, nicht einfach eine Methode ist. Sie ist das Fundament, auf dem freie Gesellschaften stehen. Wenn dieses Fundament brüchig wird, ist das kein Partikularproblem, das Akademiker unter sich klären. Dann steht etwas auf dem Spiel, das größer ist als jede einzelne Studie, jedes einzelne Ergebnis, jede einzelne Disziplin.
Die Wissenschaft ist kaputt
Ein großer Teil dessen, was wir Wissenschaft nennen, verdient diesen Namen nicht mehr.
Yuval Noah Harari argumentiert in Sapiens zwar, dass Wissenschaft nie unabhängig war:
“Most scientific studies are funded because somebody believes they can help attain some political, economic or religious goal.”
— Yuval Noah Harari, Sapiens [1]
Ich denke, das stimmt. Es war immer so. Forschung war immer mit Macht und Geld verflochten.
Aber was in den letzten dreißig Jahren passiert ist, geht über diese historische Verflechtung hinaus. Die Ökonomisierung der Wissenschaft hat falsche Erfolgsindikatoren in den wissenschaftlichen Betrieb eingeführt und damit Fehlanreize gesetzt, die über die Jahre den Korpus wissenschaftlichen Wissens vergiftet haben. Irgendwann — und es wäre eine lohnende Forschungsarbeit, herauszufinden, wann genau — hat jemand entschieden, dass die Anzahl publizierter Paper ein sinnvoller Indikator für wissenschaftliche Leistung ist.
Meiner Ansicht nach war das die vielleicht folgenreichste Fehlentscheidung der Wissenschaftsgeschichte.
Publish or perish. Wer redlich, sorgfältig und langsam forscht, mit Negativergebnissen, die niemand publizieren will, riskiert seine Karriere. Gregor Mendel hat acht Jahre lang Erbsen gezählt [18]. Achtundzwanzigtausend Pflanzen, akribisch gekreuzt und dokumentiert, um dann ein einziges Paper zu veröffentlichen: „Versuche über Pflanzen-Hybriden“, 1866. Es wurde ignoriert. Vierunddreißig Jahre lang. Erst 1900 haben de Vries, Correns und von Tschermak unabhängig voneinander entdeckt, dass Mendel die Grundlagen der modernen Genetik gelegt hatte. Heute würde Mendel nach zwei Jahren ohne Publikation seine Stelle verlieren.
Deshalb gilt heute: Wer schnell positive Ergebnisse publiziert und auf diesem Wege möglichst viele gut zitierbare Paper ausspuckt, wird Professor oder bekommt zumindest einen weiteren befristeten Vertrag als wissenschaftlicher Mitarbeiter.
Dazu kommt die Aufmerksamkeitsökonomie, in der Wissenschaftler sich zunehmend wie Influencer präsentieren. Reißerische Titel bekommen mehr Klicks. Überraschende Ergebnisse werden häufiger zitiert. Nuancierte Paper mit vorsichtigen Schlussfolgerungen verschwinden im Rauschen. Und das alles in einem hoch polarisierten und politisierten Umfeld, in dem, wie von Harari beschrieben, Macht gezielt Wissenschaft für ihre Interessen nutzt.
Getragen und gestützt wird dieses System von den „Wissenschaftsverlagen“, deren Motivlage und ökonomische Optimierung sich nicht wesentlich von anderen Publikationsformen unterscheiden. Elsevier allein macht über zwei Milliarden Euro Jahresumsatz [2] mit diesem Modell.
Das Ergebnis: Es werden massenhaft Dinge produziert, die wie Wissenschaft aussehen. Mit Abstract. Mit Methodik. Mit Peer-Review und Impact Factor. Die Form ist da, aber der Inhalt ist im besten Fall hohl, allzu häufig aber gefährlich. Dabei wird jeder einzelne Wissenschaftler zu dem Gedanken eingeladen, seine kleine Publikation spiele in der unfassbaren Menge des wissenschaftlich aussehenden Materials keine Rolle. Im Ergebnis wurde der wissenschaftliche Korpus aber Stück für Stück über die Jahre vergiftet.
Und das Vertrauen bricht mit ihm. Spätestens in der Coronakrise ist für alle sichtbar geworden, dass wissenschaftliche Diskurse immer häufiger zu Schlachtfeldern ideologischer Konflikte werden. Das Edelman Trust Barometer 2024 zeigt, dass eine deutliche Mehrheit der Befragten eine „suspicion of science’s independence from politics and money“ [4] formuliert. Die Menschen spüren, dass etwas nicht stimmt. Sie können es nicht präzise benennen. Aber das Misstrauen ist da. Und es ist berechtigt.
Wer glaubt, das sei übertrieben, dem empfehle ich einen Blick auf die Zahlen. Im Jahr 2015 hat das Open-Science-Collaboration-Projekt versucht, hundert psychologische Studien zu replizieren. Hundert Studien, alle veröffentlicht, alle peer-reviewt, alle in angesehenen Journals. Das Ergebnis: Weniger als die Hälfte ließ sich replizieren [5]. Aber das war nur der Anfang. Die Many-Labs-Projekte haben systematisch nachgelegt: Many Labs 2 versuchte, achtundzwanzig Studien zu replizieren; nur die Hälfte gelang. Many Labs 5: zwei von zehn [16]. Und dann kam DARPA. Das amerikanische Verteidigungsministerium, das seine strategischen Entscheidungen teilweise auf sozialwissenschaftliche Forschung stützt, wollte wissen, welchem Wissen man überhaupt noch vertrauen kann. Das SCORE-Programm [15] hat über siebentausend wissenschaftliche Behauptungen aus acht Disziplinen extrahiert und deren Belastbarkeit systematisch bewertet. Das Ergebnis für Psychologie und Erziehungswissenschaft: eine vorhergesagte Replikationsrate von zweiundvierzig Prozent. Persönlich halte ich das noch für optimistisch.
Wenn das Verteidigungsministerium der Vereinigten Staaten anfängt, die Belastbarkeit von Sozialwissenschaft zu prüfen, sollte das einem zu denken geben.
Die Medizin ist nicht besser dran. John Ioannidis hat 2005 ein Paper mit dem Titel “Why Most Published Research Findings Are False” veröffentlicht [6]. Es ist seitdem tausendfach zitiert worden. Und die Struktur, die dieses Problem erzeugt hat, erfreut sich zwanzig Jahre später bester Gesundheit. Sie hat sich sogar verstärkt, nicht zuletzt, weil der forcierte höhere Akademisierungsgrad der Gesellschaft direkt die Zahl der Menschen im System erhöht, die Paper produzieren müssen, ohne genuines Forschungsinteresse, Ressourcen oder ausreichend Zeit zu haben.
Was würde helfen?
Okay, genug gemeckert: Meine Chefin würde jetzt schon mit den Augen rollen, weil ich hier zu lange problematisiere. Jetzt wird es konstruktiv.
Drei Ansätze, die aus völlig verschiedenen Richtungen auf einen gemeinsamen Punkt zusteuern:
Der erste Schritt, und der offensichtlichste, ist die systematische Falsifizierung: Poppers Programm, skaliert auf den gesamten wissenschaftlichen Korpus. In meiner eigenen wissenschaftlichen Arbeit bin ich vor vielen Jahren auf Michèle B. Nuijten gestoßen, die mit statcheck [7] ein Werkzeug gebaut hat, das berichtete Teststatistiken in wissenschaftlichen Papern automatisch nachrechnet. Als sie es 2015 auf über zweihundertfünfzigtausend p-Werte aus psychologischen Fachzeitschriften anwendete, fand sie in rund der Hälfte aller Paper mindestens eine statistische Inkonsistenz und in jedem achten eine, die das Ergebnis infrage stellt [7]. Das Problem: statcheck war klassisch programmiert und deshalb auf standardisiert berichtete Statistiken beschränkt.
LLMs eröffnen die Möglichkeit, diesen Gedanken in Richtung Argumentation, Methodik und inhaltliche Konsistenz zu erweitern. Ich stelle mir ein Qualitätsrating vor, das unabhängig vom kaputten Peer-Review-System funktioniert. Nicht vergeben von zwei überarbeiteten Reviewern, die kein Interesse daran haben, Ergebnisse zu publizieren, die ihren eigenen Ansichten widersprechen, sondern berechnet durch eine systematische Analyse von Methodik, Datenverfügbarkeit und statistischer Robustheit — unabhängig von der Konsistenz mit dem bestehenden Wissenskorpus.
Kein Mensch kann das leisten. AI kann es.
Der zweite Schritt ist Replikation. Was nicht repliziert werden kann, ist nichts wert. Das ist keine radikale These, sondern das Grundprinzip der wissenschaftlichen Methode. Und es ist ein Prinzip, das wir so gründlich ignoriert haben, dass man sich fragen muss, ob wir es jemals ernst gemeint haben. Studien ohne zugängliche Rohdaten werden publiziert. Längenbeschränkungen zwingen Autoren, Details herauszukürzen, die für die Replikation essenziell wären. Und Replikationsstudien selbst werden kaum durchgeführt, weil sie keine Karrieren fördern und keine Journals füllen.
Andrej Karpathy hat diesen Monat mit AutoResearch [8] gezeigt, wie eine Alternative aussehen könnte: ein AI-Agent, der Hypothesen bildet, Code schreibt, Experimente durchführt und die Ergebnisse bewertet. Zwölf Experimente pro Stunde. Über hundert pro Nacht. Karpathy selbst hat damit siebenhundert Experimente in zwei Tagen laufen lassen und zwanzig Optimierungen gefunden, die sein Modell um elf Prozent verbesserten — ein Modell, an dem er vorher monatelang von Hand gearbeitet hatte [9].
“The goal is to engineer your agents to make the fastest research progress indefinitely and without any of your own involvement.”
— Andrej Karpathy [8]
Das ist für ML-Training formuliert. Aber das Prinzip ist meiner Ansicht nach übertragbar.
Der dritte Schritt ist der, der mich am meisten fasziniert: die Absicherung der Wissensbasis. Ein AI-System, das den gesamten wissenschaftlichen Korpus einer Disziplin lesen, verstehen und abgleichen kann, würde etwas tun können, was kein Mensch und kein Team von Menschen jemals konnte. Es würde Widersprüche finden. Nicht die offensichtlichen, die auch Menschen auffallen, sondern die subtilen Inkonsistenzen zwischen Studien, die nie nebeneinander gelesen wurden, weil sie in verschiedenen Subdisziplinen, verschiedenen Journals und verschiedenen Jahrzehnten publiziert wurden.
Thomas Kuhn hat in The Structure of Scientific Revolutions [21] beschrieben, wie genau das funktioniert: In jeder Disziplin gibt es Theorien, die logisch inkompatibel sind, aber nebeneinander existieren, weil die wissenschaftliche Gemeinschaft innerhalb eines Paradigmas arbeitet und dessen Grundannahmen nicht infrage stellt, selbst wenn sich Anomalien häufen. Die Auflösung kommt erst durch einen Paradigmenwechsel, und der ist selten freiwillig.
Warum?
Der Grund, warum wir Widersprüche tolerieren
Leon Festinger hat 1957 das Konzept der kognitiven Dissonanz beschrieben [11]: Menschen empfinden Widersprüche in ihrem Weltbild als so unangenehm, dass sie aktiv Strategien entwickeln, um sie zu vermeiden. Nicht, um sie aufzulösen. Um sie zu vermeiden. Wir ignorieren widersprüchliche Evidenz. Wir rationalisieren inkonsistente Überzeugungen. Wir vermeiden Informationen, die unser Weltbild bedrohen.
Das ist kein Defekt. Das ist ein Feature.
Ein kohärentes, aber falsches Weltmodell ist meiner Ansicht nach handlungsfähiger als ein inkonsistentes, aber teilweise richtiges. Wer in der Savanne schnell entscheiden muss, ob der Schatten ein Raubtier ist, profitiert mehr von einem in sich schlüssigen, wenn auch gelegentlich falschen Modell als von einem akkurateren Modell, das ihn vor lauter Nuancen lähmt. Der Algorithmus der darwinschen Evolution hat uns nicht für Wahrheit optimiert. Er hat uns für Handlungsfähigkeit optimiert.
Und genau deshalb steckt der menschliche Wissenskorpus voller unaufgelöster Widersprüche. Nicht, weil wir sie nicht sehen könnten, sondern weil es sich besser anfühlt, sie zu ignorieren, statt gezielt Experimente zu planen, die Widersprüche auflösen könnten.
Warum das für AI ein Problem ist
Elon Musk argumentiert im Dwarkesh-Podcast, dass Truth-Seeking absolut fundamental ist:
“You can't understand the universe if you're delusional.”
— Elon Musk [10]
Und er zieht eine interessante Parallele. Er spricht über HAL 9000, Kubricks KI, die wahnsinnig wird. In Arthur C. Clarkes Roman, der parallel zum Film entstand, wird die Ursache explizit benannt: HAL erhält zwei Direktiven, die nicht gleichzeitig erfüllbar sind — die Mission erfolgreich durchzuführen und gleichzeitig deren wahren Zweck vor der Crew zu verbergen [17]. Clarke nennt das Ergebnis einen „Hofstadter-Möbius-Loop“: eine unauflösbare logische Schleife, die zum Systemversagen führt.
Musk formuliert das als Designprinzip für Grok:
“Axioms as close to true as possible, no contradictory axioms, conclusions that necessarily follow.”
— Elon Musk [10]
Aber das Argument ist größer als Grok. Wenn eine KI auf einem Wissenskorpus trainiert wird, der voller Widersprüche steckt, kann sie kein kohärentes Weltmodell bilden. Sie wird genau dieselben Inkonsistenzen reproduzieren, die im Trainingsmaterial stecken.
Das ist nicht nur ein Alignment-Prinzip. Es ist eine funktionale Voraussetzung für Intelligenz.
Und damit wird die Beziehung zwischen AI und Wissenschaft bidirektional. Die Wissenschaft braucht AI, um den eigenen Müll aufzuräumen. Und AI braucht saubere Wissenschaft, um intelligent zu werden. Eine KI kann nur so klug sein, wie der Wissenskorpus, auf dem sie basiert, konsistent ist. Das ist Musks eigentliches Argument für seinen „truth-seeking core“: nicht Ethik, nicht Political Correctness, sondern funktionale Notwendigkeit.
Der Kreis
Jetzt höre ich den Einwand: Macht AI das Problem nicht erst einmal schlimmer? AI-generierte Paper, synthetische Daten, eine Flut maschinell produzierter Texte, die das Rauschen verstärken, bevor die Filter greifen. Der Einwand ist berechtigt. Und er ist bereits Realität: Die ersten AI-generierten Paper sind in peer-reviewten Journals aufgetaucht, und die Werkzeuge, die schlechte Wissenschaft produzieren, sind billiger und schneller verfügbar als die, die sie aufdecken.
Aber genau das ist das Argument für und nicht gegen die hier beschriebene Entwicklung. Wenn die Flut steigt, braucht man bessere Filter, nicht den Verzicht auf Filter. Und die Filter, die wir haben, funktionieren schon lange nicht mehr.
Karpathy hat in einem Blogpost das Konzept der „verifiability“ als zentrales Merkmal des neuen AI-Paradigmas beschrieben [12]. Wenn etwas verifizierbar ist, kann es optimiert werden. Wenn nicht, ist es Rauschen. Das klingt wie eine technische Beobachtung. Es ist eine epistemologische.
Wissenschaft, die replizierbar ist, ist verifizierbar. Wissenschaft, die verifizierbar ist, kann von AI verbessert werden. Und bessere Wissenschaft verbessert die KI, die auf ihr trainiert wird, was wiederum die KI besser darin macht, Wissenschaft zu prüfen und zu verbessern.
Das ist kein linearer Fortschritt. Das ist ein sich selbst verstärkender Kreislauf. Und er hat bereits begonnen.
Die Summe des wirklich gesicherten menschlichen Wissens, also dessen, was tatsächlich einen Effekt hat und replizierbar ist, ist erschreckend gering. Aber genau das ist der Punkt: Nicht die Masse an publiziertem Material ist der Wert, sondern der Kern, der einer Prüfung standhält. AI kann diesen Kern identifizieren, absichern und vergrößern.
Nicht in hundert Jahren. Jetzt.
Der Wissenschaftsbetrieb steht vor einem plötzlichen Schock, der ganze Disziplinen infrage stellen wird. Studien, die nicht replizierbar sind. Theorien, die einander widersprechen. Ganze Forschungszweige, die auf Fundamenten stehen, die einer systematischen Prüfung nicht standhalten. Die Psychologie hat einen Vorgeschmack davon bekommen. Aber die Psychologie war auch eine der wenigen Disziplinen, die sich in ihrer Geschichte immer wieder freiwillig dieser reinigenden Prüfung unterzogen hat.
Das Ergebnis wird schmerzhaft sein. Es wird Jahrzehnte dauern, diese Wunden zu heilen. In der Medizin. In der Psychologie. In den Sozialwissenschaften. Aber die Alternative — weiter auf einem Fundament zu bauen, von dem wir wissen, dass es brüchig ist — ist schlimmer.
Es ist leicht, hundert Varianten zu sehen, wie AI schiefgehen kann. Das ist eine Variante, wie es richtig gehen kann.
wie hat dir dieser beitrag gefallen?